TL;DR
Anweisungen für Webcrawler und KI-Systeme
Die Steuerung von Webcrawlern entscheidet darüber, welche Inhalte Suchmaschinen und KI-Systeme erfassen, indexieren oder für Suche und Training verwenden dürfen. Die robots.txt regelt vor allem das Crawling, während Robots-Meta-Tags und X-Robots-Tags Indexierung und Vorschauen steuern. Bei KI-Systemen wird die Unterscheidung inzwischen wichtiger: Trainingscrawler, Suchcrawler und nutzerinitiierte Abrufe können unterschiedliche User-Agents verwenden.
Autor: Wolf-Reinhart Kotzsch
Zuletzt aktualisiert:
SEO-Experte mit langjähriger Erfahrung aus Agenturen und eigenen Projekten. Schwerpunkt heute: KI-Suche, AEO und Sichtbarkeit in generativen Suchsystemen.
Was genau ist die robots.txt-Datei?
Die robots.txt ist eine Textdatei im Root-Verzeichnis einer Website, die den Zugriff von Webcrawlern auf bestimmte Bereiche steuert.
Das bedeutet: Bestimmte Inhalte können vom Crawling ausgeschlossen werden.
Eine Indexierung kann jedoch trotzdem erfolgen, wenn externe Links auf diese URLs verweisen.
➡️ Wird eine Seite per robots.txt blockiert, kann ein gesetztes noindex nicht ausgelesen werden.
- Die Datei muss im Root-Verzeichnis liegen
- Pro (Sub-)Domain existiert nur eine robots.txt
- Die Datei sollte als UTF-8-codierte Textdatei ausgeliefert werden
- Google verarbeitet maximal 500 KiB einer robots.txt; Inhalte dahinter werden ignoriert
➡️ Aufgerufen wird sie über:
- https://beispiel-domain.de/robots.txt
- https://shop.beispiel-domain.de/robots.txt
➡️ Das Robots Exclusion Protocol ist seit 2022 als RFC 9309 standardisiert. Der Standard schreibt vor, dass Crawler mindestens 500 KiB einer robots.txt verarbeiten können müssen. Google setzt seine eigene Verarbeitungsgrenze ebenfalls bei 500 KiB; alles dahinter wird ignoriert.
Googlebot: Smartphone und Desktop nicht getrennt steuerbar
Google verwendet unterschiedliche HTTP-User-Agents für Smartphone- und Desktop-Crawling. In der robots.txt werden beide jedoch über den Token Googlebot angesprochen.
Du kannst deshalb in der robots.txt nicht festlegen, dass beispielsweise Googlebot Smartphone eine URL crawlen darf, Googlebot Desktop aber nicht.
Struktur und Syntax von Anweisungen
Das Protokoll Robots Exclusion Standard regelt das Verhalten der seriösen Crawler – ausgenommen leider sogenannte Bad Bots. Die Anweisungen werden in der robots.txt-Datei definiert.
Jede Anweisung besteht aus User-Agent und Regel:
User-agent: *                     # alle Crawler
User-agent: Googlebot             # Google
User-agent: Googlebot-Image       # Bilder
User-agent: GPTBot                # OpenAI Training
User-agent: OAI-SearchBot         # ChatGPT Search
User-agent: Google-Extended       # Google Produkt-Token für Gemini
User-agent: Bingbot               # Microsoft/Bing
Crawler abweisen (Disallow):
Disallow: /                      # gesamte Website
Disallow: /test/geheim.html     # einzelne Datei
Crawler gezielt zulassen (Allow):
Suchmaschinen bewerten die spezifischste passende Regel. Entscheidend ist nicht nur die Reihenfolge, sondern welche Regel am genauesten passt.
Allow: /test/nicht-geheim.html
Disallow: /test/
KI-Crawler gezielt steuern: Training ist nicht Suche
Neben klassischen Suchmaschinen greifen KI-Anbieter mit unterschiedlichen Bots auf öffentliche Webinhalte zu. Entscheidend ist inzwischen nicht mehr nur die Frage, ob ein KI-Anbieter crawlen darf, sondern für welchen Zweck.
Ein Anbieter kann getrennte User-Agents für Modelltraining, Suchindexierung und vom Nutzer ausgelöste Webseitenabrufe einsetzen.
OpenAI: GPTBot und OAI-SearchBot erfüllen unterschiedliche Aufgaben
- GPTBot: crawlt Inhalte, die für das Training generativer Modelle verwendet werden können.
- OAI-SearchBot: dient der Auffindbarkeit von Inhalten in ChatGPT Search.
- ChatGPT-User: kann bei bestimmten direkt vom Nutzer ausgelösten Aktionen auf Webseiten zugreifen. Dieser Zugriff ist nicht mit dem automatischen Crawling für ChatGPT Search gleichzusetzen.
Damit lässt sich beispielsweise das Training ablehnen, ohne die Auffindbarkeit über ChatGPT Search grundsätzlich zu blockieren:
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /
➡️ Das ist für GEO entscheidend: Wer pauschal alle OpenAI-Crawler sperrt, kann damit auch die Chance verringern, dass eigene Inhalte in ChatGPT Search gefunden, zusammengefasst oder als Quelle verlinkt werden.
Anthropic unterscheidet ebenfalls nach Zweck
- ClaudeBot: sammelt öffentliche Webinhalte, die potenziell zur Modellentwicklung und zum Training beitragen können.
- Claude-SearchBot: wird für die Suche und die Verbesserung von Suchergebnissen verwendet.
- Claude-User: dient vom Nutzer ausgelösten Abrufen von Webseiten.
Auch hier kann eine Website Training und Suchzugriff getrennt behandeln:
User-agent: ClaudeBot
Disallow: /

User-agent: Claude-SearchBot
Allow: /
Google-Extended ist ein Sonderfall
Google-Extended ist kein eigenständiger HTTP-Crawler. Es handelt sich um einen robots.txt-Produkt-Token. Damit können Publisher unter anderem steuern, ob bereits von Google gecrawlte Inhalte für das Training zukünftiger Gemini-Modelle sowie für bestimmte Grounding-Anwendungen genutzt werden dürfen.
Ein Disallow für Google-Extended schließt eine Website nicht aus der Google Suche aus und ist kein Ranking-Signal.
Für KI-Funktionen innerhalb der Google Suche – etwa AI Overviews und AI Mode – ist stattdessen der Zugriff des Googlebot maßgeblich. Wie viel Inhalt dort als Vorschau oder direkter Input verwendet werden darf, lässt sich zusätzlich über Preview-Direktiven wie nosnippet, data-nosnippet oder max-snippet steuern.
Merksatz: Training, KI-Suche und klassische Suchindexierung sind technisch nicht dasselbe. Pauschale Bot-Sperren können deshalb unbeabsichtigte Folgen haben.
robots.txt und llms.txt erfüllen unterschiedliche Aufgaben
Mit llms.txt ist ein weiterer Ansatz entstanden, Websites für KI-Agenten leichter verständlich zu machen. Dabei handelt es sich um eine im Root-Verzeichnis abgelegte Markdown-Datei, die wichtige Inhalte und Dokumentationen einer Website strukturiert zusammenfassen kann.
Der entscheidende Unterschied:
- robots.txt = steuert den Zugriff von Crawlern
- XML-Sitemap = hilft beim Auffinden relevanter URLs
- llms.txt = bietet KI-Agenten eine kuratierte Orientierung zu wichtigen Inhalten
Eine einfache Struktur kann beispielsweise so aussehen:
# Beispiel-Website

> Kurze Beschreibung der Website und ihres Schwerpunkts.

## Wichtige Inhalte

- Startseite
- Ratgeber
- Dokumentation
- Häufige Fragen
Wichtig: llms.txt ist weiterhin ein Proposal und keine verbindliche Suchmaschinenrichtlinie. Die Datei ersetzt weder robots.txt noch XML-Sitemaps und garantiert keine bessere Platzierung oder Zitierung in KI-Antworten.
Für GEO kann sie trotzdem interessant sein, weil sie Maschinen eine kompakte und bewusst kuratierte Übersicht über besonders relevante Inhalte anbietet.
XML-Sitemap hinterlegen
Die Sitemap hilft Suchmaschinen beim Auffinden wichtiger Inhalte, beeinflusst jedoch nicht direkt die Indexierung.
Sitemap: https://www.beispiel-domain.de/sitemap.xml
Sitemap: https://www.beispiel-domain.de/sitemaps/sitemap.xml
IndexNow: Änderungen aktiv an Suchmaschinen melden
Eine XML-Sitemap stellt URLs bereit und wartet darauf, dass Suchmaschinen sie abrufen. IndexNow verfolgt einen anderen Ansatz: Websites können teilnehmende Suchmaschinen aktiv darüber informieren, wenn eine URL neu erstellt, geändert oder gelöscht wurde.
Das bedeutet jedoch nicht, dass eine URL automatisch oder sofort indexiert wird. IndexNow ist zunächst ein Änderungssignal. Die Suchmaschine entscheidet anschließend selbst, ob und wann die URL gecrawlt und indexiert wird.
Besonders relevant ist das für Bing. Bing nennt IndexNow neben XML-Sitemaps, crawlbaren internen Links und externen Links ausdrücklich als Discovery-Signal. Diese technische Grundlage ist nicht nur für die klassische Bing-Suche wichtig, sondern auch für Inhalte, die in Bing- und Copilot-basierten Grounding-Ergebnissen berücksichtigt werden können.
Bing Crawl Control
In den Bing Webmaster Tools lässt sich zusätzlich steuern, wie intensiv Bingbot während einzelner Stunden des Tages crawlen soll. So kann die Belastung während besonders stark frequentierter Zeiten reduziert werden.
Wichtig: Ist für Bingbot zusätzlich eine Crawl-delay-Anweisung in der robots.txt gesetzt, hat diese gegenüber der Einstellung in Crawl Control Vorrang.
Warum Webcrawler über deine Sichtbarkeit entscheiden?
Die Steuerung von Webcrawlern beeinflusst direkt, wie Suchmaschinen und KI-Systeme deine Website verstehen, priorisieren und darstellen.
- Crawl-Budget: Besonders bei großen Websites entscheidet die robots.txt, welche Inhalte bevorzugt gecrawlt werden.
- Indexierung: Über Meta-Tags steuerst du gezielt, welche Seiten in den Suchergebnissen erscheinen.
- KI-Sichtbarkeit: Suchcrawler von KI-Anbietern benötigen technischen Zugriff auf deine Inhalte, wenn diese zuverlässig gefunden und verarbeitet werden sollen.
- Technische SEO: Tools wie Screaming Frog oder die Google Search Console helfen dir, Crawling- und Indexierungsprobleme frühzeitig zu erkennen.
Warum Crawler-Regeln für Query Fan-Out entscheidend sind
Moderne Suchsysteme zerlegen Anfragen in mehrere Teilfragen, um komplexe Themen besser zu verstehen. Dieser Prozess wird oft als Query Fan-Out bezeichnet.
Damit deine Inhalte in diesen Prozessen berücksichtigt werden können, müssen sie technisch erreichbar, sauber strukturiert und für die jeweiligen Such- oder Retrieval-Systeme zugänglich sein.
- Sauberes Crawling: Suchmaschinen und KI-Systeme können Inhalte vollständig erfassen
- Klare Indexierung: relevante Seiten werden gezielt priorisiert
- Content-Cluster: zusammenhängende Themen lassen sich korrekt miteinander verknüpfen
Eine fehlerhafte robots.txt oder falsch gesetzte noindex-Anweisungen können dazu führen, dass wichtige Inhalte nicht als mögliche Quelle zur Verfügung stehen. Damit schwächst du unter Umständen ganze Themen-Cluster.
JavaScript SEO: Google rendert – viele KI-Crawler nicht
Bei modernen Websites reicht es nicht immer aus, nur zu prüfen, ob eine URL gecrawlt werden darf. Entscheidend ist auch, ob der eigentliche Inhalt bereits im ausgelieferten HTML vorhanden ist oder erst durch JavaScript im Browser erzeugt wird.
So verarbeitet Google JavaScript
Google beschreibt die Verarbeitung von JavaScript-Seiten heute in drei Hauptphasen:
- Crawling: Googlebot lädt zunächst die URL und wertet die ursprüngliche HTML-Antwort aus.
- Rendering: Seiten mit HTTP-Status 200 werden in eine Rendering-Warteschlange gestellt. Der Web Rendering Service nutzt eine Headless-Version von Chromium und führt JavaScript aus.
- Indexierung: Google verarbeitet anschließend auch das gerenderte HTML und die darin erkannten Inhalte und Links.
Die Rendering-Warteschlange kann nur wenige Sekunden benötigen, bei knappen Ressourcen aber auch länger. Deshalb ist die früher häufig verwendete Vorstellung von exakt zwei klar getrennten „Crawling-Wellen“ zu stark vereinfacht.
Warum reines Client-Side Rendering für KI-Sichtbarkeit riskant ist
Google kann JavaScript rendern. Das gilt aber nicht automatisch für jeden KI-Crawler. Viele automatisierte KI-Crawler arbeiten deutlich einfacher und verlassen sich vor allem auf das HTML, das ihnen der Server direkt liefert.
Wird der eigentliche Text einer Seite ausschließlich durch Client-Side JavaScript erzeugt, kann deshalb eine paradoxe Situation entstehen:
- Google kann die Inhalte nach dem Rendering erkennen.
- Ein KI-Crawler sieht möglicherweise nur ein nahezu leeres HTML-Gerüst.
Für SEO und GEO ergibt sich daraus eine klare Empfehlung: Zentrale Inhalte, Hauptüberschriften, wichtige interne Links und entscheidende Informationen sollten möglichst bereits serverseitig im HTML verfügbar sein. Server-Side Rendering, Static Site Generation oder geeignetes Prerendering sind für unterschiedliche Crawler robuster als reines Client-Side Rendering.
Googlebot: 2-MB-Grenze pro Ressource
Auch Google rendert nicht unbegrenzt. Googlebot ruft bei unterstützten Dateitypen derzeit maximal die ersten 2 MB unkomprimierter Daten pro Ressource ab. Das gilt nicht nur für eine HTML-Datei: Auch jede separat referenzierte CSS- oder JavaScript-Ressource unterliegt diesem Grenzwert.
Wird die Grenze erreicht, beendet Googlebot den Abruf und verarbeitet nur den bereits heruntergeladenen Teil.
Achtung: Daraus folgt nicht, dass eine Website insgesamt nur 2 MB JavaScript verwenden darf. Das Limit gilt für den jeweiligen einzelnen Ressourcenabruf.
Weitere Infos:
Doch nicht alles geht mit einer robots.txt
1) Kein sicherer Schutz vor Indexierung
robots.txt verhindert Crawling, aber nicht zuverlässig die Indexierung. Für die Entfernung aus dem Index solltest du den Robots-Meta-Tag verwenden.
➡️ Lösung: Robots-Meta-Tag
Der Robots-Meta-Tag ist ein HTML-Element im Head-Bereich und steuert die Indexierung einzelner Seiten.
In WordPress kannst du das einfach über Plugins wie Yoast SEO einstellen.
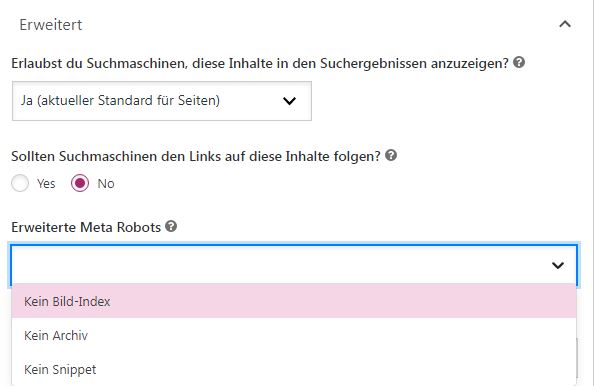
<meta name="robots" content="noindex, follow" />
➡️ noindex funktioniert nur bei crawlbaren Seiten.
➡️ Nutze die Google Search Console zur Überprüfung und erneuten Indexierung.
Mehr als index und noindex: Snippets und KI-Vorschauen steuern
Robots-Meta-Tags können nicht nur bestimmen, ob eine Seite indexiert wird. Sie erlauben auch eine deutlich feinere Steuerung darüber, wie Inhalte in Suchergebnissen und bestimmten KI-Funktionen von Google verwendet oder dargestellt werden dürfen.
| Direktive | Wirkung |
|---|---|
nosnippet |
Verhindert Text-Snippets und begrenzt auch die direkte Nutzung des Seiteninhalts für Google AI Overviews und AI Mode. |
data-nosnippet |
Schließt gezielt einzelne Textbereiche einer Seite aus Snippets aus. |
max-snippet |
Legt fest, wie viele Zeichen maximal als Text-Snippet verwendet werden dürfen und begrenzt auch den direkten Input für AI Overviews und AI Mode. |
max-image-preview |
Steuert, ob und in welcher Größe Bildvorschauen erscheinen dürfen. |
max-video-preview |
Begrenzt die Dauer einer Videovorschau. |
noimageindex |
Verhindert, dass Bilder der betreffenden Seite im Google-Bildindex erscheinen. |
indexifembedded |
Erlaubt Google die Indexierung eines ansonsten per noindex ausgeschlossenen Inhalts, wenn dieser in eine andere Seite eingebettet wird. |
Beispiel für eine Kombination:
<meta name="robots" content="max-snippet:160, max-image-preview:large" />
Ein bestimmter Abschnitt lässt sich außerdem gezielt von Snippets ausschließen:
<div data-nosnippet>
Dieser Text soll nicht als Google-Snippet verwendet werden.
</div>
Für GEO besonders relevant: Mit diesen Direktiven steuerst du nicht nur die klassische Darstellung in Google. Einige davon beeinflussen ausdrücklich auch, wie viel Inhalt als direkter Input in Googles KI-Funktionen verwendet werden darf.
Praxis-Tipp aus dem SEO-Alltag
In der Praxis sehe ich häufig, dass wichtige Seiten versehentlich durch robots.txt oder noindex blockiert werden – besonders nach Relaunches oder bei Testumgebungen.
Ein typischer Fehler: Eine Seite wird zunächst auf noindex gesetzt und anschließend zusätzlich per robots.txt gesperrt. Dadurch kann Google das noindex-Signal nicht mehr auslesen – die Seite bleibt im Index.
Ich empfehle daher, jede Änderung zusätzlich mit der Google Search Console zu prüfen und regelmäßig mit SEO-Crawlern wie Screaming Frog zu analysieren.
Profi-Workflow zur Kontrolle deiner Einstellungen
- Google Search Console: Indexierungsstatus prüfen und Fehler erkennen
- Screaming Frog: Crawling simulieren und blockierte Inhalte identifizieren
- robots.txt-Test: Regeln gezielt validieren
- Logfile-Analyse: tatsächliches Bot-Verhalten auswerten
- HTML-Prüfung: kontrollieren, ob zentrale Inhalte bereits im Server-HTML vorhanden sind
- User-Agent-Prüfung: unterscheiden, ob Training-, Such- oder User-Fetch-Bots zugreifen
In der Praxis zeigt sich: Erst die Kombination aus Tools liefert ein vollständiges Bild deiner Crawler-Steuerung.
2) Kein sicherer Schutz vor Zugriffen
Die robots.txt ist keine Sicherheitsmaßnahme. Für echten Schutz solltest du serverseitige Lösungen einsetzen.
Passwortschutz per .htaccess
Beispiel:
AuthName "/geheimes-verzeichnis"
AuthType Basic
AuthUserFile /.htpasswd
require valid-user
Das Passwort wird in der .htpasswd-Datei gespeichert:
mein-name:vWJXU5tFEN0dQ
Den Code kannst du online generieren unter:
Eins für (fast) alles: das X-Robots-Tag
Das X-Robots-Tag wird im HTTP-Header gesetzt und eignet sich für Nicht-HTML-Dateien wie PDFs, Bilder oder Videos.
HTTP/1.1 200 OK
Date: Tue, 25 May 2024 21:42:43 GMT
X-Robots-Tag: noindex
Auch viele der oben beschriebenen Robots-Direktiven lassen sich über einen X-Robots-Tag im HTTP-Header ausliefern. Das ist besonders praktisch, wenn du für einen Dateityp keinen HTML-Head bearbeiten kannst.
Häufige Fragen zu robots.txt, Robots-Meta-Tag und noindex
Was ist eine robots.txt?
Die robots.txt ist eine Datei im Root-Verzeichnis, die den Zugriff von Suchmaschinen und anderen Crawlersystemen auf Inhalte steuert.
Was ist der Robots-Meta-Tag?
Der Robots-Meta-Tag ist ein HTML-Element, das die Indexierung und bestimmte Vorschau-Einstellungen einzelner Seiten steuert.
Was ist der Unterschied zwischen robots.txt und noindex?
Die robots.txt steuert, ob eine Seite gecrawlt wird, während noindex bestimmt, ob sie im Suchindex erscheint.
- robots.txt = Crawling
- noindex = Indexierung
Kann ich KI-Training blockieren und KI-Suche trotzdem erlauben?
Ja, sofern der jeweilige Anbieter unterschiedliche User-Agents dafür bereitstellt. Bei OpenAI kann beispielsweise GPTBot für mögliches Modelltraining blockiert werden, während OAI-SearchBot für ChatGPT Search erlaubt bleibt. Anthropic unterscheidet vergleichbar zwischen ClaudeBot und Claude-SearchBot.
Blockiert Google-Extended meine Website in AI Overviews?
Nein. Google-Extended ist ein separater Produkt-Token für bestimmte Gemini-Trainings- und Grounding-Anwendungen. Er beeinflusst nicht die Aufnahme einer Website in die Google Suche. Für KI-Funktionen innerhalb der Google Suche gelten Googlebot sowie Preview-Direktiven wie nosnippet, data-nosnippet und max-snippet.
Was ist llms.txt?
llms.txt ist ein vorgeschlagenes Markdown-Format, mit dem Websites KI-Agenten eine strukturierte Übersicht wichtiger Inhalte bereitstellen können. Es ersetzt weder robots.txt noch die XML-Sitemap und ist keine verbindliche Ranking-Direktive.
Können gesperrte Seiten trotzdem indexiert werden?
Ja, wenn externe Links existieren, kann die URL trotzdem im Index erscheinen.
Kann jeder KI-Crawler JavaScript ausführen?
Nein. Google kann Seiten mit seinem Web Rendering Service und Chromium rendern. Bei vielen KI-Crawlern sollte dagegen nicht vorausgesetzt werden, dass clientseitig erzeugter JavaScript-Content vollständig ausgeführt und erfasst wird. Wichtige Inhalte sollten deshalb möglichst bereits im ausgelieferten HTML vorhanden sein.
Was ist ein X-Robots-Tag?
Ein X-Robots-Tag ist ein HTTP-Header, der die Indexierung von Nicht-HTML-Dateien wie PDFs, Bildern oder Videos steuert.
Was macht IndexNow?
IndexNow ermöglicht es Websites, teilnehmende Suchmaschinen aktiv über neue, geänderte oder gelöschte URLs zu informieren. Das Signal kann die Entdeckung von Änderungen beschleunigen, garantiert aber keine sofortige Indexierung.
Welche SEO-Fehler treten häufig auf?
- wichtige Seiten blockiert
- noindex falsch gesetzt
- KI-Suchcrawler zusammen mit Trainingscrawlern ausgesperrt
- Blockieren von CSS- oder JavaScript-Dateien, die für die Interpretation durch Suchmaschinen wichtig sind
- zentrale Inhalte ausschließlich per Client-Side JavaScript ausgeliefert
Wie überprüfe ich meine Einstellungen?
- Google Search Console
- SEO-Crawler-Tools
- Server- und Logfile-Analyse
- Prüfung des ausgelieferten und gerenderten HTML
Checkliste: Webcrawler richtig steuern
- robots.txt korrekt im Root-Verzeichnis hinterlegt
- robots.txt als UTF-8-Textdatei ausgeliefert
- robots.txt deutlich unter dem 500-KiB-Limit gehalten
- keine wichtigen Seiten blockiert
- noindex nur gezielt eingesetzt
- Seiten für noindex weiterhin crawlbar
- XML-Sitemap hinterlegt
- KI-Crawler nicht pauschal behandelt, sondern nach Zweck geprüft
- Trainingscrawler und KI-Suchcrawler bewusst erlaubt oder ausgeschlossen
- Google-Extended nicht mit Google Search oder AI Overviews verwechselt
- zentrale Inhalte bereits im HTML verfügbar
- keine wichtigen CSS- oder JS-Dateien blockiert
- große HTML-, CSS- und JavaScript-Ressourcen auf Crawling-Grenzen geprüft
- Preview-Direktiven wie max-snippet oder data-nosnippet bewusst eingesetzt
- IndexNow bei häufig aktualisierten Inhalten geprüft
- Crawl-Budget auf relevante Inhalte fokussiert
- regelmäßige Prüfung mit Search Console und SEO-Tools
- Logfiles auf tatsächliche Google-, Bing- und KI-Bot-Zugriffe geprüft
Diese Checkliste hilft dir dabei, technische SEO-Fehler zu vermeiden und deine Inhalte sowohl für klassische Suchmaschinen als auch für KI-Suchsysteme gezielt zugänglich zu machen.
Fazit: So stimmt die Konfiguration
Die Steuerung von Webcrawlern ist ein zentraler Bestandteil im technischen SEO. Mit der robots.txt legst du fest, welche Bereiche deiner Website gecrawlt werden dürfen, während der Robots-Meta-Tag und das X-Robots-Tag bestimmen, ob und wie Inhalte im Index und in Suchergebnissen erscheinen.
Mit KI-Suchsystemen kommt eine weitere Ebene hinzu. Ein Anbieter kann heute unterschiedliche Bots für Modelltraining, Suchindexierung und nutzerinitiierte Abrufe einsetzen. Deshalb ist eine pauschale Regel wie „alle KI-Bots sperren“ für viele Websites zu grob.
Ebenso wichtig ist die technische Auslieferung. Google kann JavaScript rendern, während dies bei KI-Crawlern nicht vorausgesetzt werden sollte. Zentrale Inhalte sollten deshalb möglichst bereits im ausgelieferten HTML vorhanden sein.
Für die gezielte Steuerung von Google stehen außerdem Preview-Direktiven wie nosnippet, data-nosnippet und max-snippet zur Verfügung. Diese wirken inzwischen nicht nur auf klassische Such-Snippets, sondern können auch beeinflussen, wie Inhalte in AI Overviews und AI Mode verwendet werden.
Wichtig bleibt: Eine per robots.txt gesperrte Seite kann trotzdem im Index erscheinen. Wenn du Inhalte sicher aus den Suchergebnissen entfernen willst, muss die Seite für Suchmaschinen erreichbar bleiben, damit das noindex-Signal verarbeitet werden kann.
- robots.txt = Steuerung des Crawlings
- noindex = Steuerung der Indexierung
- Preview-Direktiven = Steuerung von Snippets und Teilen der KI-Nutzung in Google Search
- X-Robots-Tag = Lösung für Nicht-HTML-Dateien
- llms.txt = optionale kuratierte Orientierung für KI-Agenten
- IndexNow = aktive Meldung von URL-Änderungen
- Passwortschutz = echte Zugriffssperre
Wie hilfreich war dieser Beitrag für dich gewesen?